Работа кластера отказоустойчивости
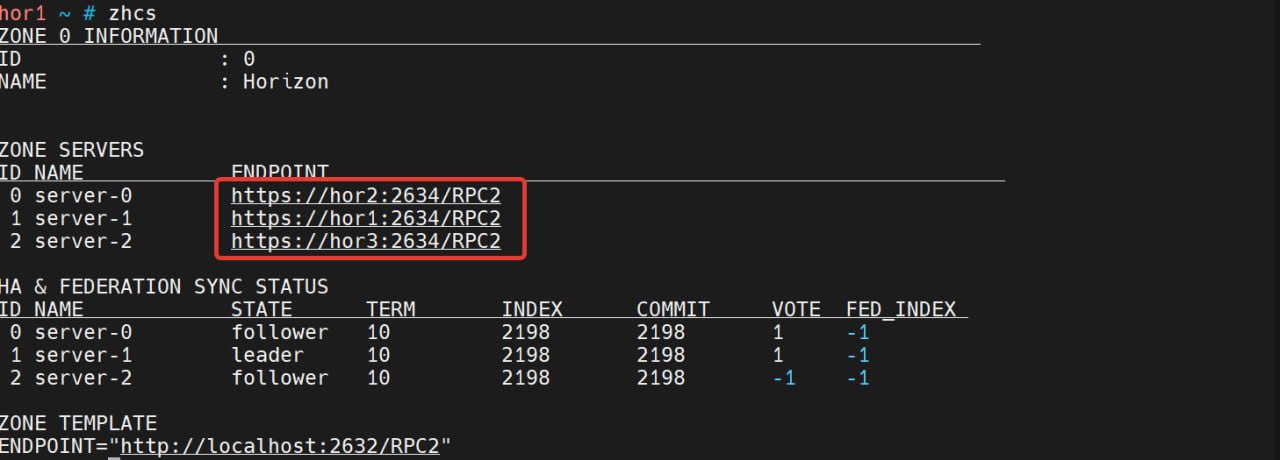
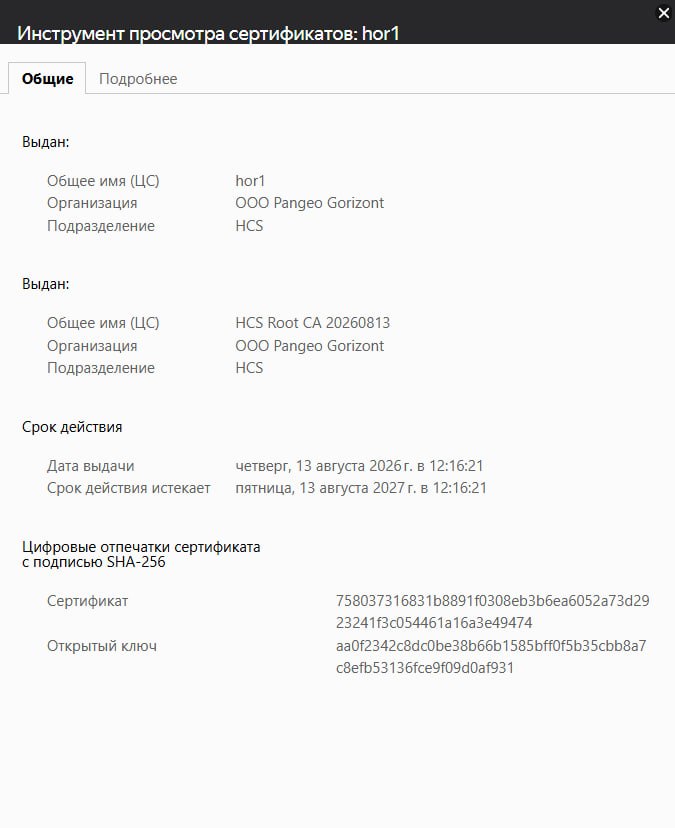
Работа RAFT кластера по сертификатам SSL и https
Общение механизма кластеризации между хостами стало более безопасным и надежным от перехватов.
Изменен скрипт пересборки кластера, обновлен oned.conf и Caddyfile\
При обновлении необходимо разобрать кластер, установить новый контейнер, заменить указанные файлы из нового контейнера и собрать новый кластер.
Это можно сделать с любого хоста с СГУ.
Действия при потере хостов кластера
Ситуация 1 – Потеря хоста кластера
В случае потери хоста без СГУ (т.е. состоящего кластере, но не участвующего в управлении системой), при условии, что включен кластер ВД для ВМ СГУ организует перезапуск ВМ на других хостах кластера. В данной ситуации если ресурсов (ЦПУ или RAM) для ВМ будет недостаточно, или расположение на других узлах противоречит правилам размещения для данной ВМ, она изменит свое состояние на НЕИЗВЕСТНО. В этом случае необходимо добавить/высвободить ресурсы в кластере или скорректировать правила размещения данной ВМ, соответственно. Если хост потерян безвозвратно, его следует удалить из СГУ, это необходимо для того, чтобы мониторинг системы не засорял лог файлы. Чтобы добавить прежний хост после решения проблемы, или новый взамен прежнего необходимо проверить сетевые настройки и настройки хранилищ (должны совпадать с остальными хостами кластера), после этого добавить хост в кластер.
Ситуация 2 – Потеря хоста отказоустойчивого кластера СГУ
В случае потери 1 из хостов отказоустойчивого кластера, его статус изменится на «error». Для проверки необходимо использовать:
ihcs onezone show 0
или:
zhcs
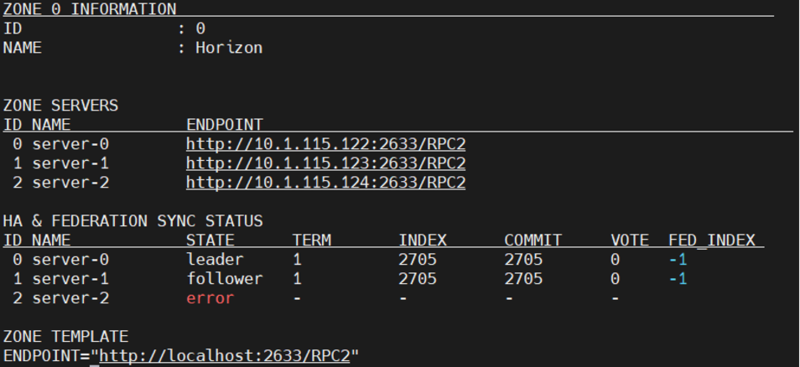 Так как потеря одного хоста сильно не влияет на работу системы, механизм отказоустойчивости отработает корректно, и лидер сменится, однако в данном случае кластер работает в аварийном режиме, и потеря еще одного хоста приведет к неработоспособности кластера ВД для СГУ, чтобы привести его в должный вид и избавить от излишнего логирования мониторинга системы, необходимо удалить узел, а затем в терминале лидера удалить узел из кластера ВД СГУ и проверить выполнение операции:
ihcs onezone server-del 0 <host_id>
ihcs onezone show 0
где <host_id> - идентификатор узла в RAFT-кластере, колонка ID
Данные действия проводятся только для хоста со статусом error. В противном случае вы рискуете повредить HA кластер СГУ.
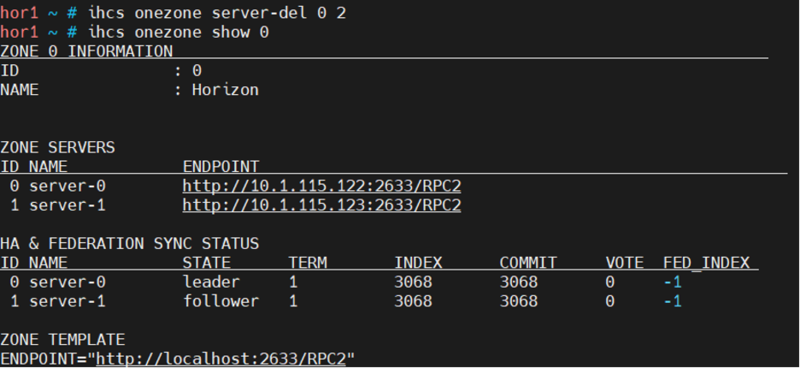
После выполнения этих шагов, для восстановления прежней работы кластера, необходимо восстановить поврежденный хост или настроить новый с идентичными настройками потерянного хоста (установлен гипервизор, СГУ, сетевые параметры и т.д.) и запустить контейнер с СГУ.
После этого необходимо НА ЛИДЕРЕ:
docker exec -t hcs onezone show 0
docker exec -t hcs onedb backup -u oneadmin -p horizon -d opennebula /var/tmp/dump.sql
scp /var/tmp/dump.sql <IP>:/var/tmp
где <IP> - адрес хоста, который будет добавлен в кластер СГУ
На хосте, добавляемом в кластер:
docker exec -t hcs su -s "/bin/sh" -c "one -f stop" oneadmin
docker exec -t hcs su -s "/bin/sh" -c "sunstone-server stop" oneadmin
docker exec -t hcs onedb restore -f -u oneadmin -p horizon -d opennebula /var/tmp/dump.sql
docker kill hcs
На ЛИДЕРЕ (в примере добавляется восстановленный или новый хост в замен server-2):
docker exec -t hcs onezone server-add 0 --name server-2 --rpc http://<IP>:2633/RPC2

scp -p /var/lib/docker/volumes/hvol/_data/auth/.one/* <IP>:/var/lib/docker/volumes/hvol/_data/auth/.one/

scp -pr /var/lib/docker/volumes/hvol/_data/certs <IP>:/var/lib/docker/volumes/hvol/_data/

scp -pr /var/lib/docker/volumes/hvol/_data/etc <IP>:/var/lib/docker/volumes/hvol/_data/

scp -pr /var/lib/docker/volumes/hvol/_data/hac <IP>:/var/lib/docker/volumes/hvol/_data/

scp -pr /var/lib/docker/volumes/hvol/_data/keys <IP>:/var/lib/docker/volumes/hvol/_data/
где <IP> - адрес хоста, который будет добавлен в кластер СГУ
На ХОСТЕ:
sed -i 's/.*SERVER_ID\s*=.*/    SERVER_ID     = <ID>,/' /var/lib/docker/volumes/hvol/_data/etc/one/oned.conf

docker restart hcs
где <ID> - номер добавленного хоста в кластере ВД СГУ (можно посмотреть на текущем лидере в выводе zhcs или ihcs onezone show 0, колонка ID), в данном примере – 2.
После этого контейнер с СГУ на добавленном хосте необходимо запустить:
docker start hcs
И через минуту на лидере проверить, что новый кластер ВД СГУ корректно собрался, в выводе присутствуют три сервера, нет серверов с ошибками, индексы и коммиты идентичны, или на добавленном сервере со временем догоняют индексы и коммиты на лидере:
ihcs onezone show 0
Ситуация 3 – Потеря 2-х и более хостов отказоустойчивого кластера СГУ
При потере всех хостов кластера отказоустойчивого СГУ, кроме 1 необходимо выполнить следующие действия:
Проверить какой из хостов находится в рабочем состоянии
ihcs onezone show 0
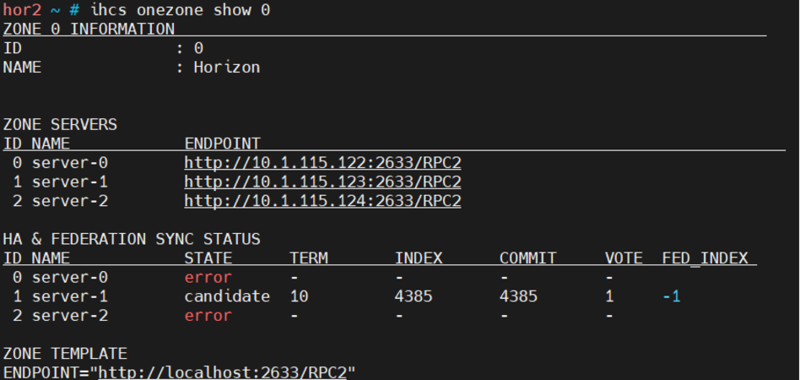
Подключиться терминалу его гипервизора и отредактировать в файле /var/lib/docker/volumes/hvol/_data/etc/one/oned.conf строке 47 изменив запись SERVER_ID = <id>, на запись SERVER_ID = -1
Далее необходимо остановить сервисы СГУ и sunstone:
ihcs su -s "/bin/sh" -c "one -f stop" oneadmin
ihcs su -s "/bin/sh" -c "sunstone-server stop" oneadmin
Затем необходимо сделать резервную копию базы данных СГУ:
docker exec -t hcs onedb backup -u oneadmin -p horizon -d opennebula /var/tmp/dump.sql
и каталогов с ключевыми файлами:
mkdir -p /var/tmp/backup/auth/.one
cp /var/lib/docker/volumes/hvol/_data/auth/.one/* /var/tmp/backup/auth/.one/

cp -r /var/lib/docker/volumes/hvol/_data/certs /var/tmp/backup/
cp -r /var/lib/docker/volumes/hvol/_data/etc /var/tmp/backup/
cp -r /var/lib/docker/volumes/hvol/_data/hac /var/tmp/backup/
cp -r /var/lib/docker/volumes/hvol/_data/keys /var/tmp/backup/
Далее необходимо перезапустить контейнер с СГУ:
docker restart hcs
И проверить статус кластера:
ihcs onezone show 0
хост должен перейти в режим solo. После этого СГУ хоста будет доступно и позволит управлять системой.
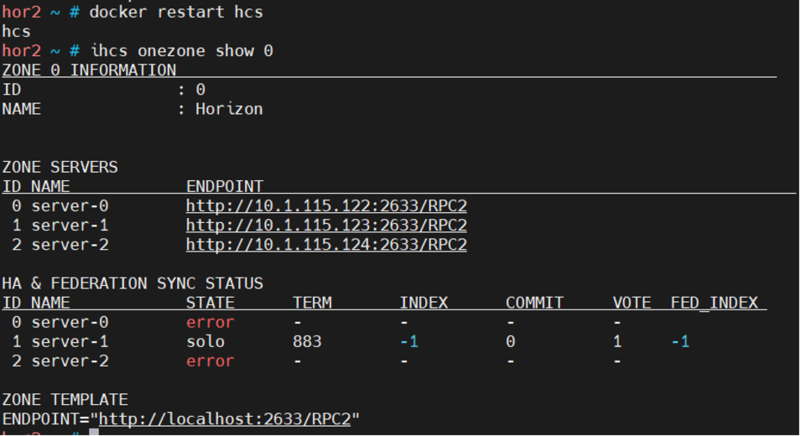
Данные действия являются последней возможность подключиться к системе управления и выполнить действия, необходимы для спасения и восстановления системы, в случае наступления такой ситуации рекомендуется все действия производить через техническую поддержку, так как Вы рискуете потерять данные в системе.
Далее в терминале оставшегося хоста удалить все узлы начиная с тех, которые находятся в состоянии error, и еще раз проверить состояние кластера:
ihcs onezone server-del 0 <host_id>
ihcs onezone show 0
В выводе последней команды блок HA & FEDERATION SYNC STATUS должен отсутствовать.
После этого Необходимо еще зайти в СГУ, проверить что виртуальная инфраструктура находиться в актуальном состоянии, отключить нерабочие узлы и перераспределить находящиеся на них ВМ по другим узлам и, при необходимости, запустить.
Дальнейшие действия зависят от возможности и сроков восстановления узлов, на которых были установлены вышедшие из строя экземпляры контейнеров с СГУ участвовавшие в RAFT.
1) В случае если узлы могут быть оперативно восстановлены, на них должны быть восстановлены или сохранены сетевые настройки, контейнер с СГУ должен быть переразвернут заново;
2) В случае если узлы не могут быть восстановлены или сроки восстановления существенные, тогда есть смысл развернуть контейнеры с СГУ на других узлах инсталляции и собрать RAFT с ними (см.1.1.6 Настройка СГУ «Горизонт-ВС», настройка отказоустойчивости).
Миграция сервера управления между хостами HA кластера
- Развёрнут отказоустойчивый кластер RAFT СГУ из 3 серверов на базе гипервизоров c СГУ
- На АРМ администратора произведена авторизация в веб-интерфейсе СГУ по плавающему адресу HA-кластера под учётной записью с правами администратора
- Администратор залогинен на консоль гипервизора под учётной записью root
1. В консоли гипервизора определить на каком сервере находится лидер кластера, выполнив команду:
zhcs
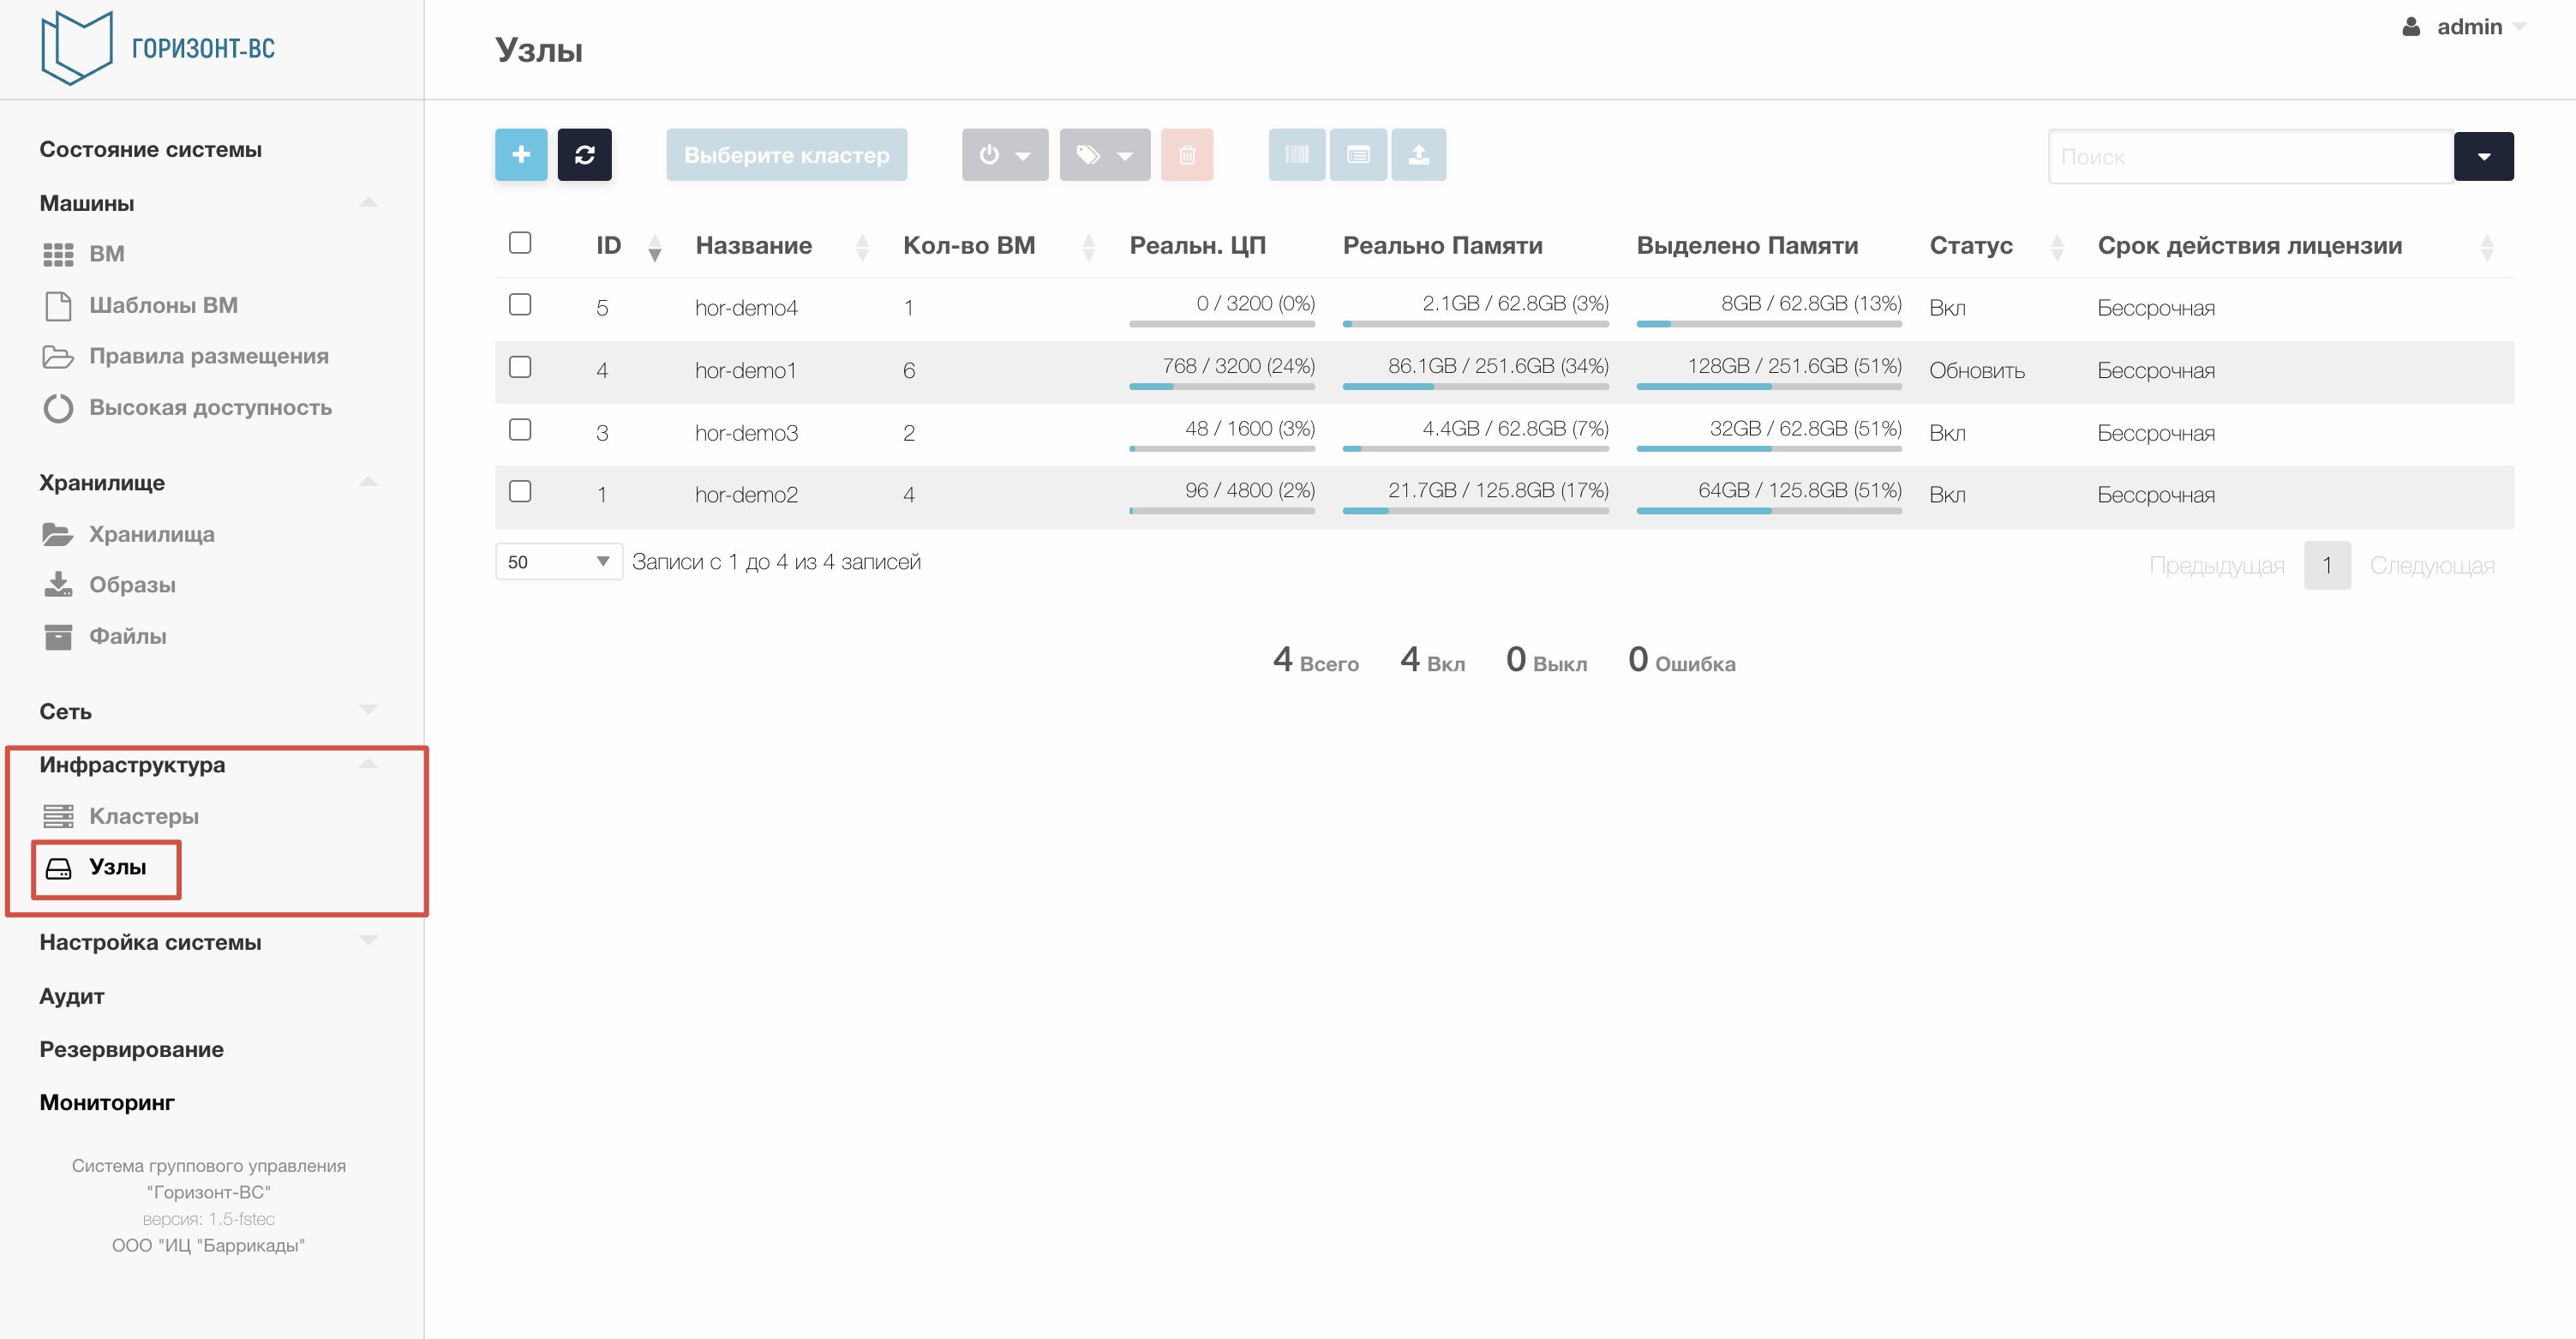
2. В веб-интерфейсе СГУ перейти к списку узлов СГУ --> Боковая панель --> Инфраструктура --> Узлы
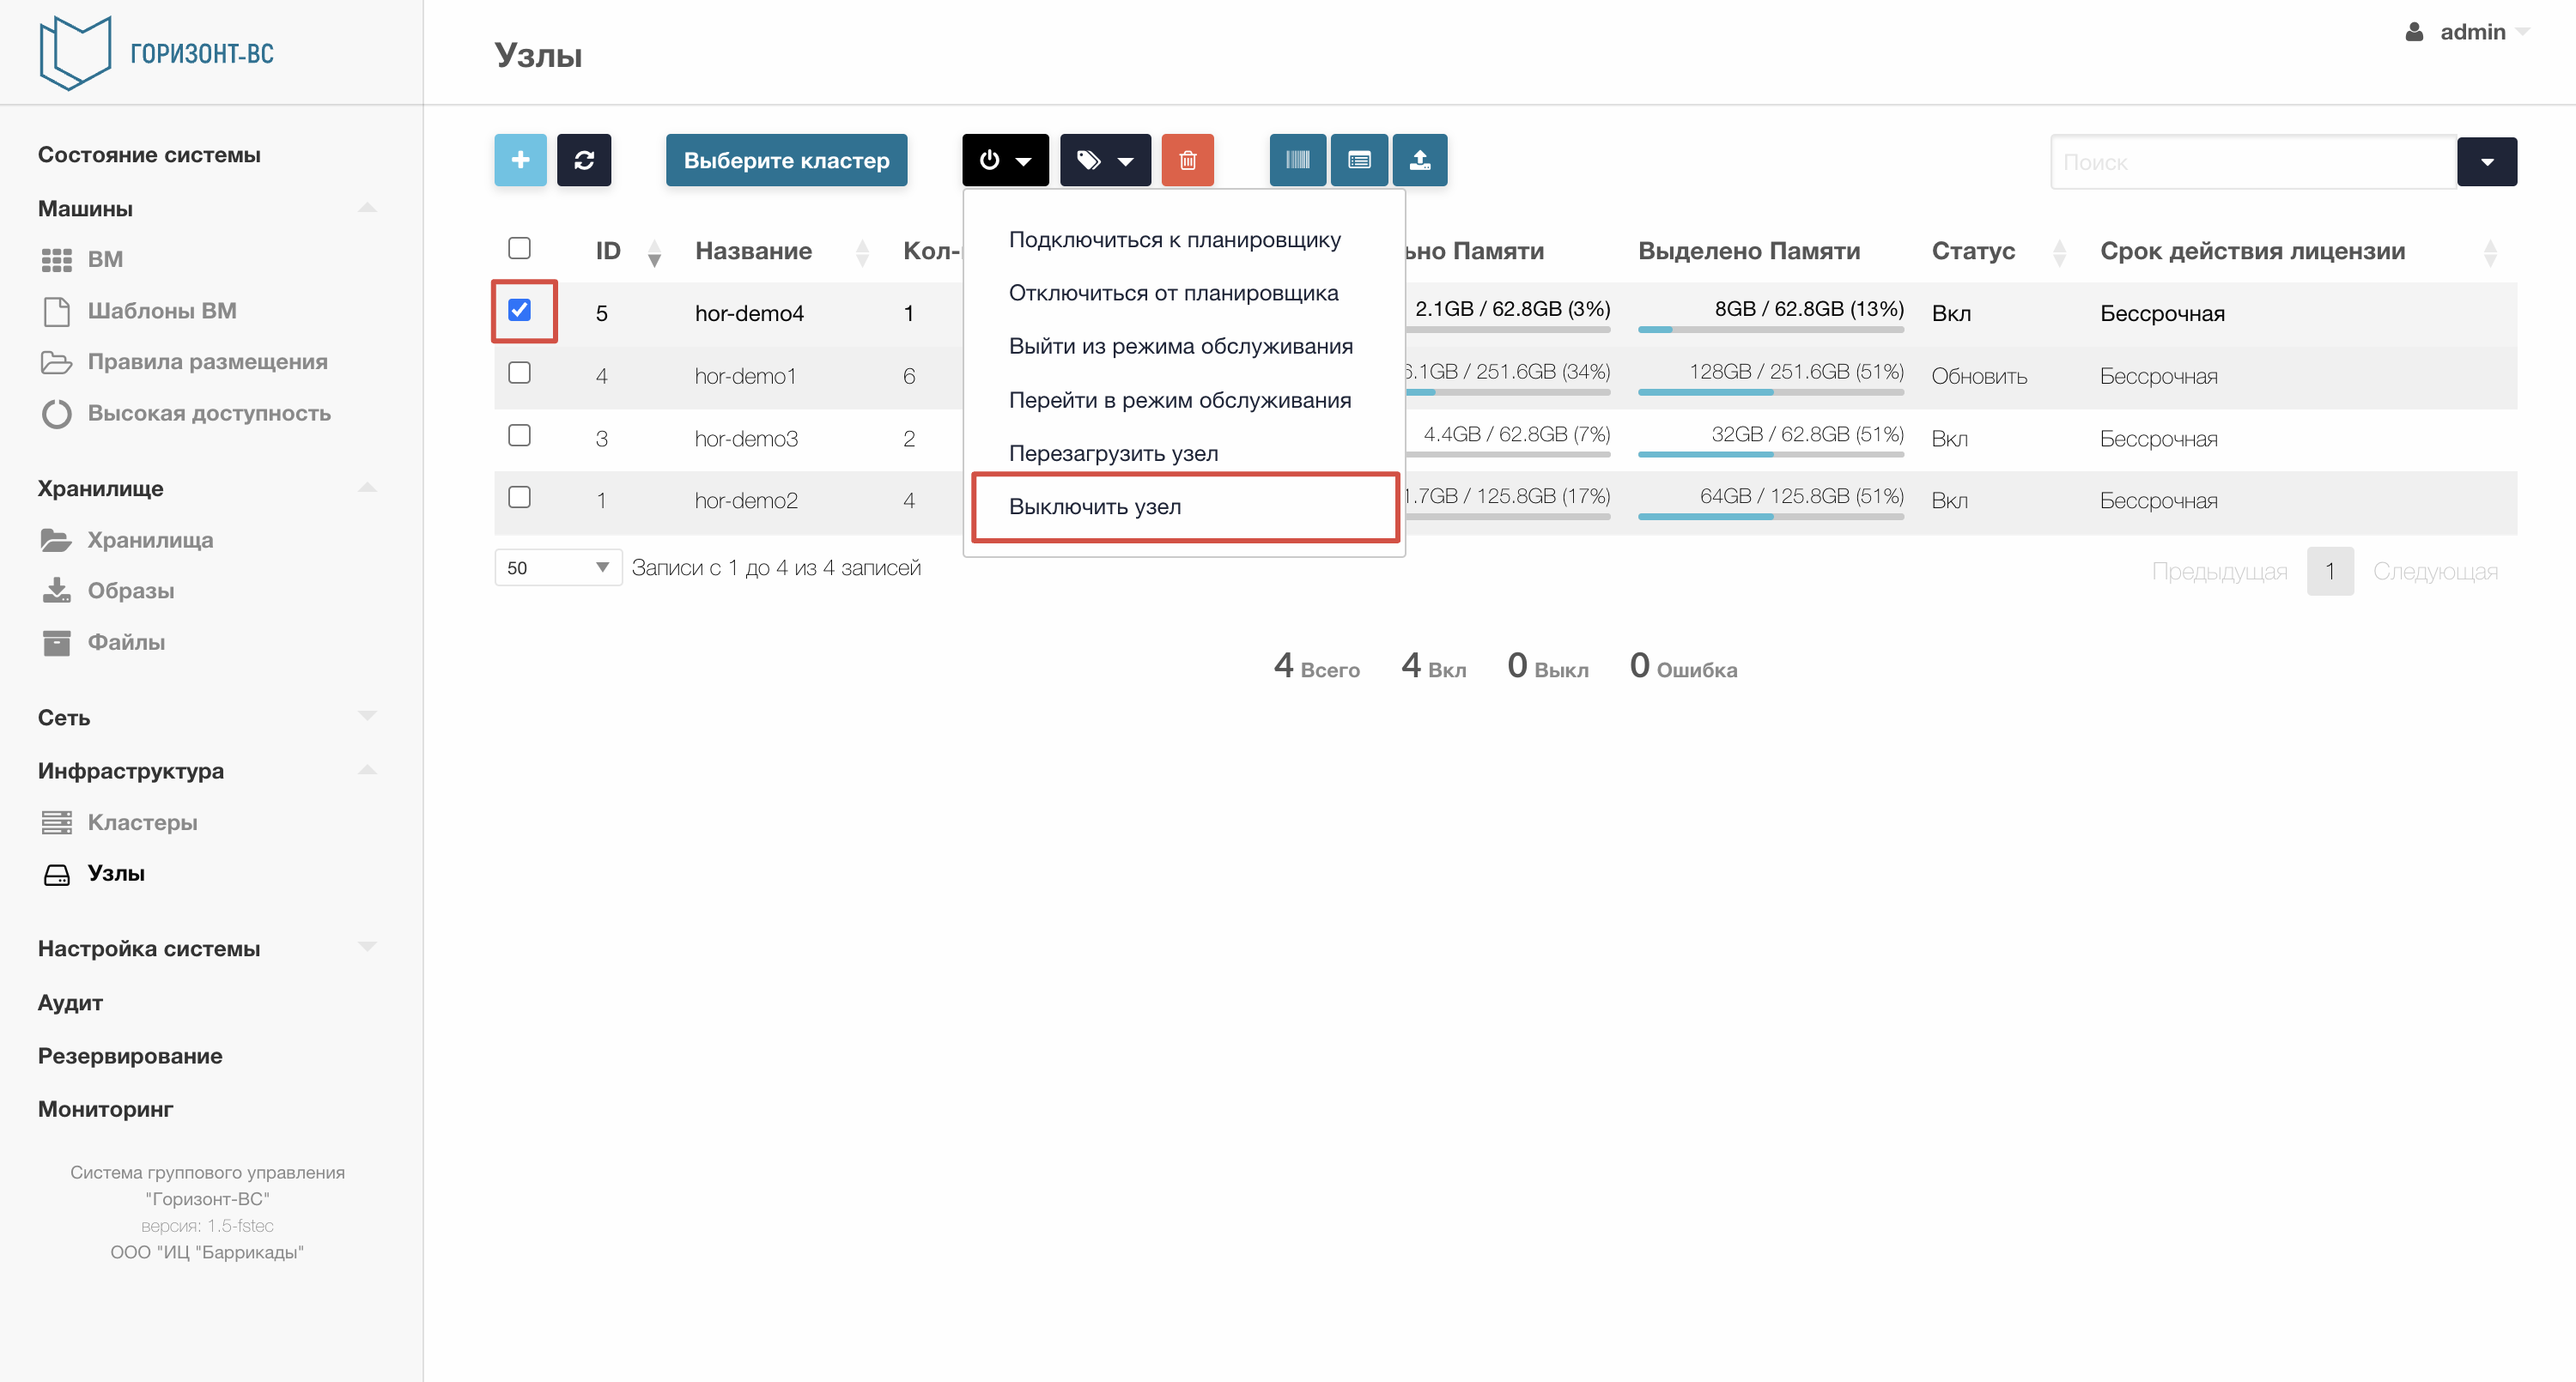
3. Выключить узел, являющийся лидером (определяется на шаге 1): Выставить флаг на Узле-лидере --> Кнопка питания --> Выключить узел Выждать время, необходимое для выключения сервера и выбора лидера
4. Обновить страницу браузера по предыдущему адресу и авторизоваться в веб-интерфейсе СГУ